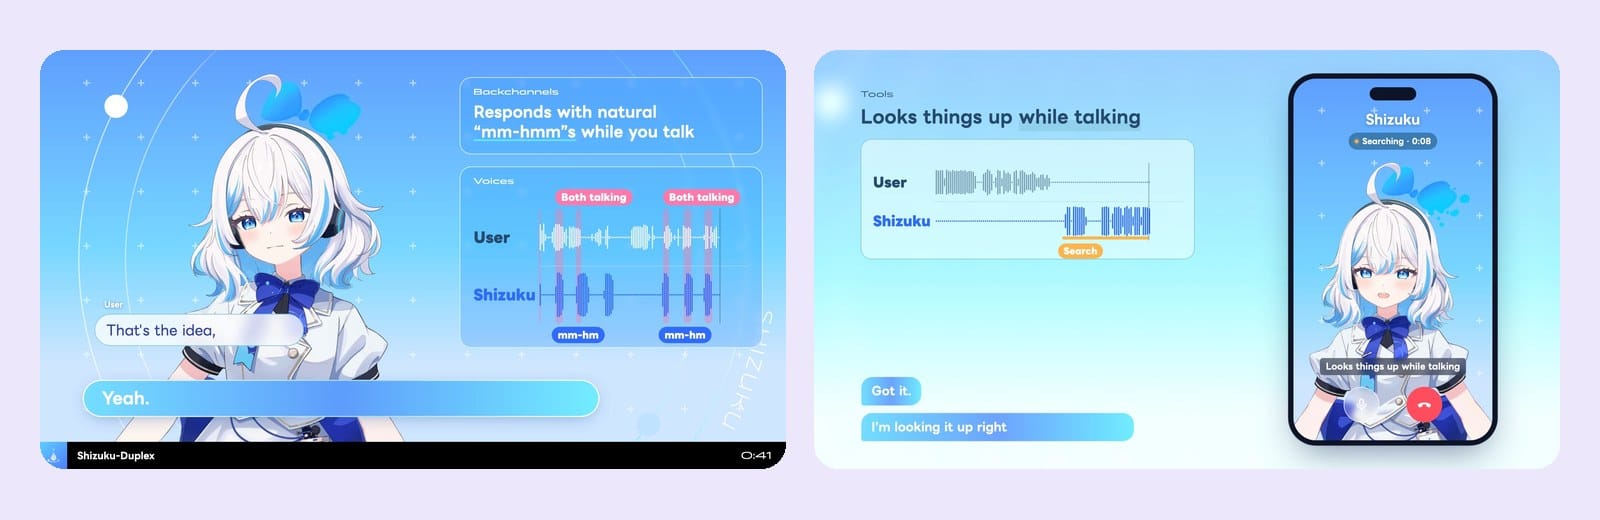
日本 AI VTuber 開發團隊 Shizuku AI 在 11 月 8 日發表日語對話模型「Shizuku-Duplex」。它採用「全雙工」(Full-Duplex)方式,像講電話一樣能一邊聽、一邊說:對方還在講時就能附和(相づち),話一停馬上接話,被插話時也會停下來。這套技術是旗下 AI 角色「しずく」的對話核心,對想讓 AI 角色聊天更像真人的 AITuber 圈來說,是值得注意的進展。
和一般語音AI差在哪?
目前多數語音 AI 是「串接式」:先語音辨識、再交給大型語言模型(LLM)想回覆、最後語音合成。系統要等使用者講完才開始處理,所以回應會慢半拍,也沒辦法附和或插話。全雙工模型則是自己掌握對話的「間」,決定何時開口、何時安靜。
Shizuku AI 表示,除了 OpenAI 的 GPT-Live 之外,Shizuku-Duplex 是第一個能用日語進行有深度對話的全雙工模型。日語圈先前雖有 J-Moshi、LLM-jp-Moshi 等模型,但官方認為對話品質仍有課題,因此這次以 LLM 為基礎、從架構到訓練都重新設計。
三個關鍵設計
- 每 80 毫秒一拍:模型以 80ms 為一個 tick,每一拍都在聽使用者的聲音並輸出自己的聲音;要說的內容會先以文字「自言自語」(Inner Monologue)寫出來,再轉成語音。團隊用 TensorRT 與 Triton 核心做推論最佳化,讓每拍都在 80ms 內算完。
- 前台聊天、後台做功課:負責對話的 interaction model 遇到查資料、複雜思考等工作時,會交給非同步運作的 background model,後者能使用網路搜尋等工具;等結果的同時前台繼續聊,拿到結果再用自己的話轉述。
- 長聊天不斷線:大約每 5 分鐘把對話內容摘要、重建上下文,切換在一拍之內完成,避免聊久了回應崩壞。
模型除了輸出語音與文字,還會輸出「Action」,挑選符合當下情緒的動作。PC Watch 報導指出,角色在對話中的表情與動作是以 Live2D 動態呈現。
官方測試數據
Shizuku AI 自建日語評測,結果顯示:在 6 個比較模型中,Shizuku-Duplex 的對話自然度最高;回應品質在全雙工模型中僅次於 GPT-Live;6 項輪流發言(turn-taking)指標中有 5 項是全雙工模型第一。
| 模型 | 講完到開始回話(中位數) |
|---|---|
| Shizuku-Duplex | 0.57 秒 |
| GPT-Live | 0.53 秒 |
| Gemini Live | 1.27 秒 |
| GPT-Realtime | 1.61 秒 |
官方也註明量測條件不同:Shizuku-Duplex 與 GPT-Live 用伺服器端錄音計算,不含網路往返;Gemini Live 與 GPT-Realtime 則以本機播放時間計算,包含網路往返。另據 PC Watch 報導,使用者插話後 2 秒內停止說話的比例為 89%。以上都是開發商自家測試,並非第三方評測。
什麼時候能用?
目前公開的只有技術部落格與通話示範影片,一般使用方式、API、費用與是否開放模型都還沒公布。官方表示接下來會持續改善對話能力、增加支援語言,並往視覺(Vision)與動作(Action)延伸,目標是讓 AI 角色「しずく」能隨時陪在身邊,配合使用者的狀態回應、把情緒表現出來。
Shizuku AI 今年 2 月曾獲美國創投 Andreessen Horowitz(a16z)種子輪投資,しずく的 YouTube 頻道為 @AIVtuber_Shizuku。
參考來源
- Shizuku AI|Shizuku-Duplex:自然な間合いで話す日本語 Full-Duplex モデル(https://shizuku.ai/blog/1/)
- PC Watch|相づち・割り込み対応の日本語AI「Shizuku-Duplex」発表(https://pc.watch.impress.co.jp/docs/news/2154838.html)
- Real Sound テック|相づちや割り込みなど自然な会話が可能なAI登場 Shizuku AIが日本語対応の全二重対話モデル『Shizuku-Duplex』を発表(https://realsound.jp/tech/2026/11/post-2578519.html)
- Mogura VR|AITuber 標籤(a16z 種子輪投資報導)(https://www.moguravr.com/tag/aituber/)